高可用原则:万一原则
中国有句俗话,不怕一万,就怕万一。这里指的是哪怕考虑周全,但如果有遗漏,会造成严重的后果。对人对事情来说,考虑周全应该是常态,极小概率的意外,则有较大的破坏力。比如
- 出门远行应该带上足够的钱,避免意外缺钱导致行程受阻
- 天晴也带一把雨伞
- 拉高河堤,即使洪水百年一遇
- 加固学校建筑,即使地震可能是千年一遇。
- 极地探险,带上比预期时间更长的粮食和能源
对于软件系统来说,极小概率事情发生往往带来较大的破坏,因此需要我们在设计系统的时候采用悲观设计,编码时候防御性编程。
悲观设计
**悲观设计,**指的是设计的时候假设坏事一定会发生,需要提前考虑如何解决这些坏事,并做出设计设计,比如下面列举的意外一定会发生
- 下游服务一定会超时响应,或者不响应(系统本身不响应,或者防火墙阻断了响应)
- 下游响应的格式错误。
- 来自上游的调用,一定会有流量突变情况。
- 系统用户数增长超过预期
- 上游请求的响应,上游收到后,未能发送确认应答
- 系统收到上游的同一个请求多次
- 即使规定了API的参数格式,上游一定会违反这种规范。
- 系统依赖的类库,因为安全原因需要紧急更新
- 系统依赖的硬件出现故障,如内存或者CPU被其他进程占用
- 或者依赖的容器漂移到其他物理机
- 系统版本更新后未能正常运行,数据库更新后未能正常运行
- 数据库等扩容运维人员预计1分钟,但实际花了更长时间30分钟。
- 运营商,云计算商出现故障
- 黑客攻击、运维人员错误配置了网关理由策略,或者防火墙过滤策略
通过分析系统架构,尤其是部署架构和软件架构,架构师思考架构图中的每个连线和每个组件,假定上述状况一定会发生,思考应该如何完善系统。曾在国内头部电商公司担任架构,跨团队评审设计的时候,遇到一个支付系统需要调用户优惠券服务,涉及如下
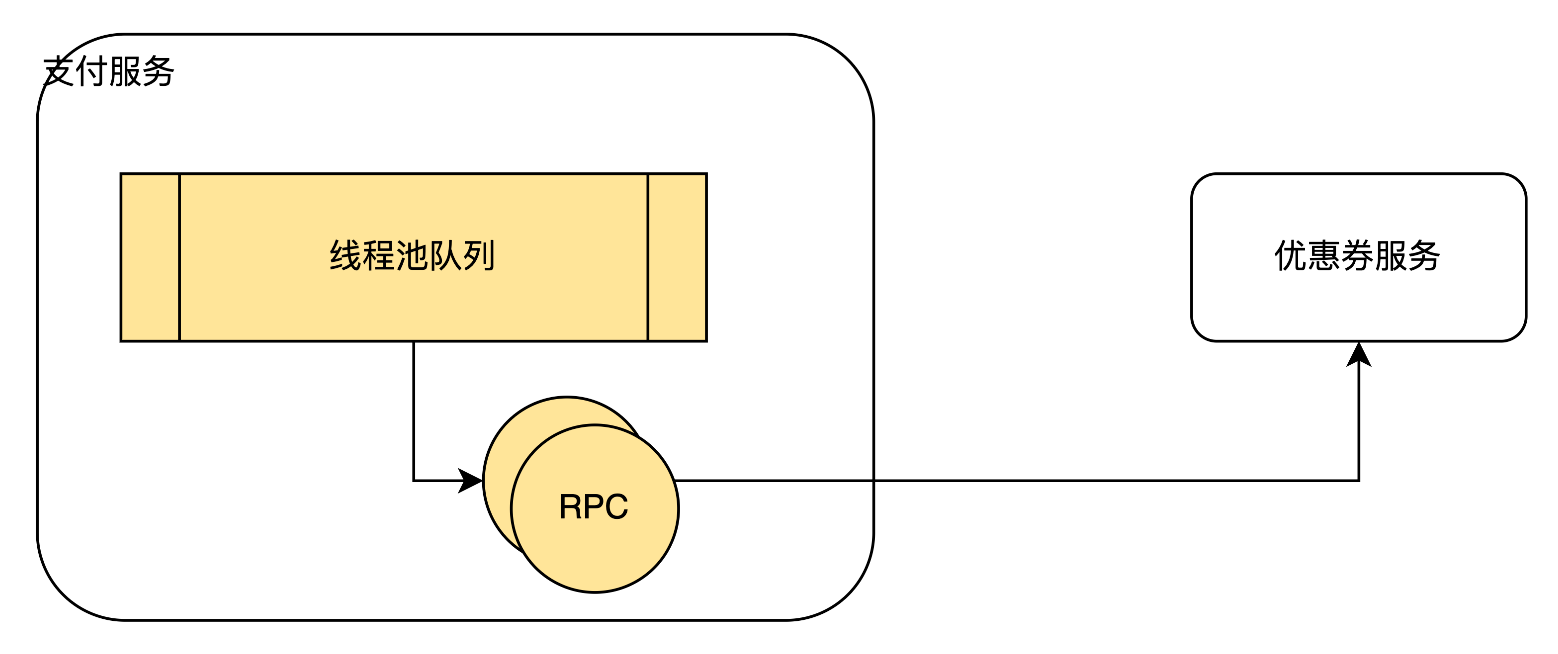
支付团队有如下悲观的考虑
- 已经考虑到如果调用优惠券服务,如果出现阻塞,会影响支付服务本身的响应上游的速度。因此考虑使用异步编程方式,将优惠券发送任务放到一个线程池里执行
- 支付团队进一步考虑到如果优惠券服务暂时不可用,可以重试N次调用,配置为重试4次。
架构团队在评审此方案时候,指出此方案可能会造成严重后果。主要问题在于重试调用可能导致线程得不到释放回到线程池,从而造成线程池队列挤压了大量的任务,会造成内存溢出导致支付服务变得不可用。其悲观考虑如下
- 通过配置固然提高了系统的可修改性,但如果不小心运维人员配置了一个较大数值,比如40次。在优惠券服务不可用情况下极容易出现支付服务内存溢出
- RPC调用,有可能因为网络故障,或者优惠券服务忙(比如正在重启,或者系统故障无法重启)的情况下,导致访问超时。如果超时时间设置的较长,比如4秒,如果加上重试4次,导致线程20秒被此任务占用
架构团队向支付团队提供了多种战术解决此问题,比如快速失败,采用消息中间件异步处理等。本书第9章和第10章将介绍这些战术
这个评审实际是在支付系统故障后发起的,我的架构组同事通过支付系统软件架构找到这个线程池的问题。当然,也可以通过内存溢出后Dump 内存找到问题,这将在《12.2 JVM可观测》说明
另外一个来自于国内头部物联网的例子,当时物联网还在发展初期,在线设备只有十几万。当应用系统需要订阅设备的上下线事件,或者属性变化事件(比如全屋应用,屋中设备一个属性变化触发全屋设备状态重新计算和控制),可以通过消息平台来实现。物联网只需要把设备上下线,以及属性推送到消息凭条。应用系统订阅相应的Topic即可,DEVICE_ONLINE,DEVICE_OFFLINE,DEVICE_ATTRIBUTE 。
这种设计过于乐观了,没有考虑到短短几年,设备就从数万发展到数千万。业务系统需要跟随扩展以处理海量的设备上下线消息,以及海量的属性上报。比如一个简单的应用系统,之前只需要每秒能处理几条设备上下线,但在线设备多了后,它不得不跟随扩容以处理每秒数千条设备上下线消息,以及每秒几十万的属性上报消息。 哪怕大部分设备不属于此系统,一个使用量很小的系统也不得不投入巨大的硬件成本。如下一个初期只有几万蓝牙Mesh的服务,也不得不处理海量消息。
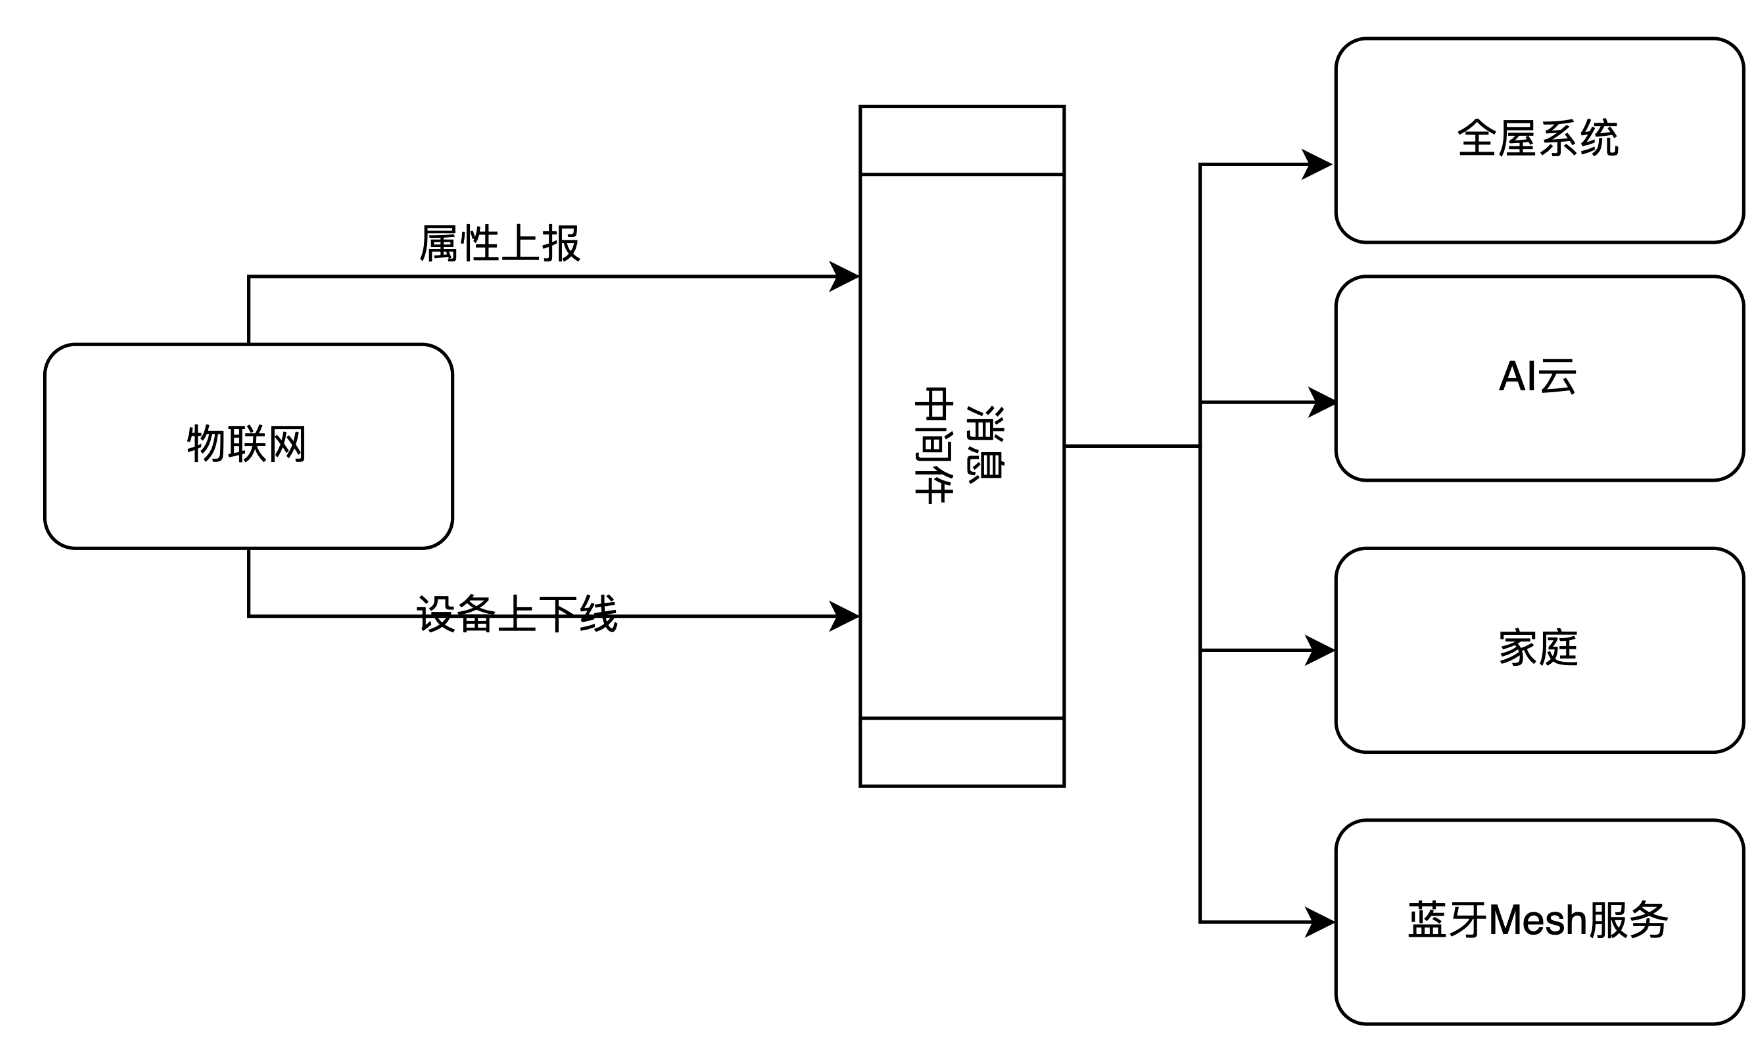
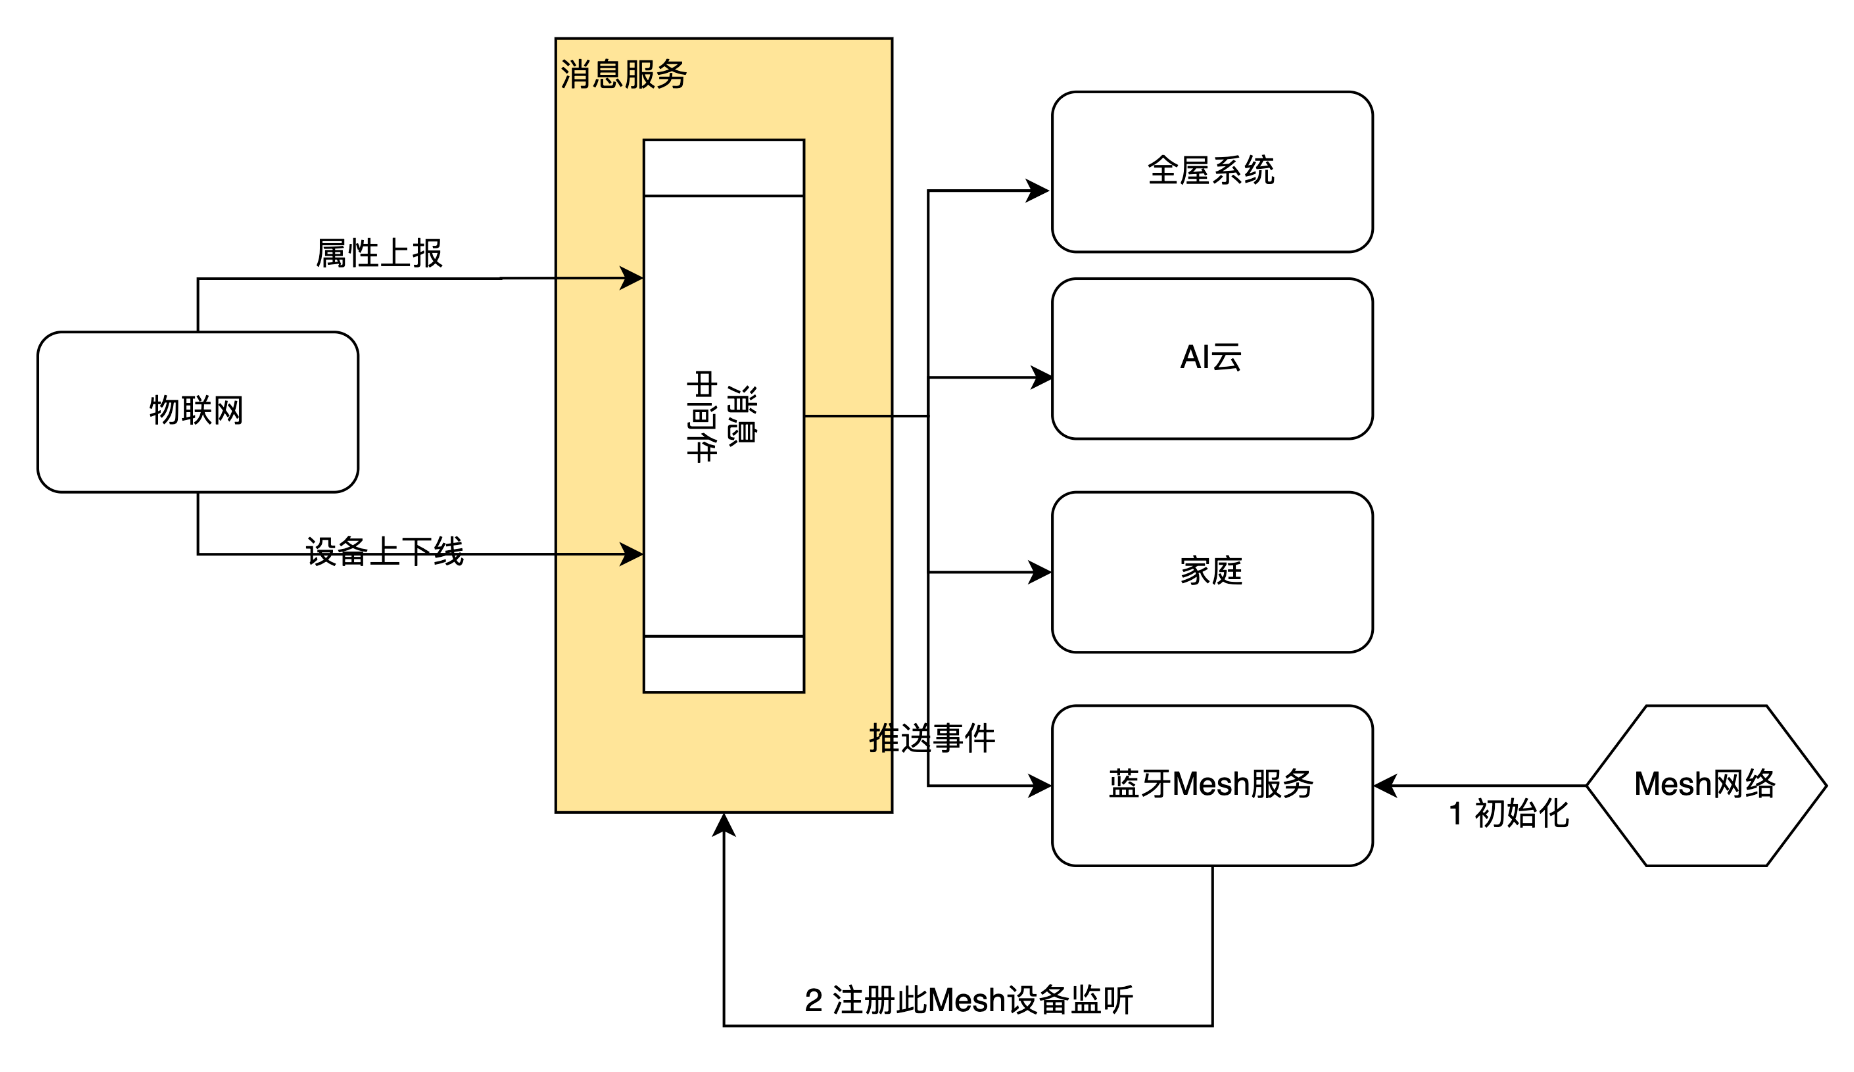
解决办法是提供基于产品级别或者设备级别的消息订阅的消息系统。比如蓝牙Mesh服务,可以在构建Mesh网络时候,在消息服务注册此蓝牙设备,并申明监听设备上下线事件。 全屋服务则只监听加入全屋系统的设备,以及只监听属性和告警变化的事件,而不需要监听所有属性事件和所有的设备。
防御性编程
防御性编程同悲观设计,在实施编码时候,要做好参数校验,异常处理,植入可观测性代码,最后对功能进行兜底以保证系统不会局部错误导致系统崩溃。本书《1.9 软件系统可观测性》中列举了一个Hello Word就是一个典型的防御性编程例子。
与防御性编程相反的是乐观编程,作者在某头部电信厂商工作时候,出现一个匪夷所思的事情,分布式系统中,一个团队需要根据下游返回的异常栈,得出具体的错误原因。这是因为下游团队如果要调整为返回错误码,则需要上下游一起改动,在工期临近时候,决定根据异常栈提供的行号信息,自行分析出故障原因。 比如,当异常栈显示PayServiceImp 行号是50行,则可能是参数错,如果是100行,则是余额不足。这种解决方案运行了几年都很成功,直到下游团队来了个新手,删除了PayServiceImp如下一行注释。在评审过程中又恰好忽略了下游需要根据行数判断异常类型。
// 支付接口
public void pay(Dto dto) throws PayException{
    //System.out.println(dto); 新手删除了这一行,感觉没毛病
}
这种修改导致上游因为解析不到错误行数,又未对此情况做兜底处理,系统报了空指针。最后PayServiceImp改成这个样子,强调不要修改任何内容
//支付接口,千万别新增或者删减行
public void pay(Dto dto) throws PayException{
    //System.out.println(dto);  新版本又补回来这一行
}
当时此方案的评审过程中,如果有人提出万一PayServiceImp内容被修改后,行号定位不准怎么办就好了。团队拍着胸脯保证不会改!
旅游探险中,最忌讳的是“来都来了,走这条路看看”,设计方案,也忌讳“先搞一个临时方案”
以我个人经验,产品架构师大部分精力用在设计异常业务流程,而架构师大部分精力都用在悲观设计上,程序员大部分编码精力也是用在防御性编程上,这是IT人员的工作常态。作为一个IT从业者,你未曾悲观过,那你还不是一个技术资深的从业者