无状态高可用:分布式协调
有些业务场景需要分布式节点之间进行协调,以实现领导节点选取,分布式锁,以及分布式限流等功能:
| 场景 | 描述 |
|---|---|
| 领导节点选取 | 从多个节点中选取一个节点,此节点能决定集群资源分配。比如f定时任务只能有一个节点执行,在集群里选择一个节点作为领导节点执行定时任务。当领导节点宕机,其他节点将被选为下一个领导节点。领导节点常用来作为redis,kafka的中间件集群的主备节点的选取 |
| 分布式互斥 | 分布式锁保证集群中只有一个节点能访问受保护资源,以防止干扰。比如保护某个文件服务。分布式互斥也能辅助实现幂等,比如一个订单号只能一个订单服务节点处理。 |
| 分布式限流 | 当服务API,或者资源服务访问需要限制并发或者限流时候使用分布式限流。比如数据导出和下载服务,可能耗费数据库资源。需要限制并发数。 |
| 集群信息注册 | 集群中的节点能注册自己信息并能获取到其他节点的信息,也能感知到其他节点上下线。 |
| 起跑线 | 需要为多个分布式任务设定起跑线,当满足某个条件的时候,才开始一起执行。 |
实现分布式节点之间的协调,最有效的方式是通过高可用的协调服务节点实现,协调服务决定谁是领导节点,以及当领导节点下线时候,选择另外一个节点作为领导节点并通知其他节点
暂时无法在飞书文档外展示此内容
协调服务也能完成分布式锁功能,协调服务决定哪个节点获准访问被保护的资源,其他节点将在协调服务里排队等待。如果节点完成资源访问或者节点宕机,那么协调服务将通知他节点获得访问资源的权限。
相对于这种中心化实现协调的方法,还有去中心化的算法,比如在分布式互斥场景中,各个节点可以构造一个逻辑环,环中可以传递令牌,哪个节点持有令牌,就获得了一个分布锁。非中心的算法通常对节点之间相互通信,实现较为复杂。另外一种是使用Raft协议实现分布式共识,协调服务通常借鉴这种协议实现。
实现协调服务可以使用zookeeper、etcd、consul等工具。本章将介绍zookeeper来说明如何实现分布式协调服务,下一章有状态服务将介绍协调服务实现的原理
Zookeeper
Zookeeper来源于Apache Hadoop子项目,是一个高性能,分布式的,开源分布式应用协调服务。分布式应用可以基于它实现协调服务,比如同步,集群,领导选取,以及分布式系统的配置管理,命名服务。它被设计为易于编程,使用文件系统目录树作为数据模型。服务端跑在java上,提供java和C的客户端 API。
Zookeeper(下面简称zk)有如下特点:
- 简单的API和数据结构完成协调服务,zk 提供了易于理解的数据结构来完成协调服务,其java api非常简单。curator 进一步封装了这些api,直接提供了分布式协调服务而不需要关心细节。
- 分布式,不会出现单点故障,一般来说,至少部署3台zk以避免单点故障。客户端如果连接的zk宕机,客户端将自动连到另外一台
性能测试结果表明非常快,ZK本生的性能非常好,在读多写少场景,部署在普通2C的服务器,TPS能到达10万,即可以处理分布式系统的管理协调任务,如选举领导,也能胜任较大并发量的业务协调处理,如业务处理的分布式锁
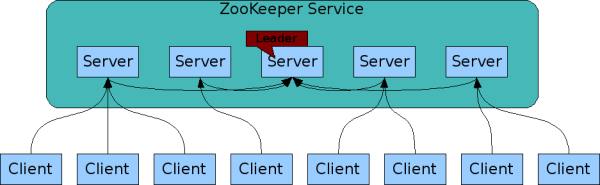
如上图是Client就是我们的分布式节点,Server表示ZK集群中的一个节点,多台Server协作保证ZK集群的高可用性其中一个Server会被选举为领导节点,它负责数据的更新操作,并广播到其他Server,数据更新会在大部分Server达成一致后才更新。分布式节点应用连接一个Server,如果这个Server变得不可用,则会连接另外一个。如果领导节点不可用,则剩下的Server会再选出一个节点
关于Zookeeper的数据同步以及领导选取的过程,将在有状态高可用一章介绍。
ZK 提供的命名空间(name space) 类似文件系统,每一个节点都是通过路径来表示,不同的是,节点可以包含一定的数据,2M字节,这些节点可以用来存放业务信息,如配置信息等。
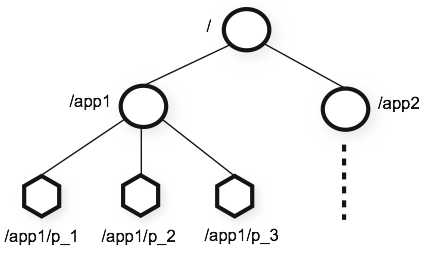
节点还包含了更新的版本,时间戳。有一种特殊的节点是临时节点,创建节点的会话存在,节点就存在,一旦会话结束,如客户端创建的链接断掉,或者客户端主动关闭此会话,则节点会被删除。还可以指定节点为顺序节点,创建节点的时候,自动为节点增加一个序列号,并且序列号递增
节点可以被监控,一旦节点变化,如删除,或者节点数据变化,客户端就会收到此事件,此监控失效。客户端可以调用API继续监控这个节点。
使用Zookeeper
通过官网下载ZK,安装后可以进入bin目录运行如下命令启动
>./zkServer.sh start为了简单起见,只使用一个ZK Server来演示。此ZK Server就是Leader Server
再次运行zkCli命令连接本地的ZK Server,并进入命令控制台,在命令控制台,我们可以通过模拟客户端命令来实现分布式协调
>zkCli.sh可以运行help命令可以查看所有命令的使用方法,运行ls / 查看根目录
[zk: localhost:2181(CONNECTED) 0] ls /
[zookeeper]
create 创建节点
>create /config 0
>create /config/db.username xiandafu
创建一个config节点,节点内容是字符"0",第二条在config目录下创建一个节点db.username,节点的数据是字符"xiandafu"。
- create -e 创建临时节点,一旦用户会话结束,则节点自动删除。
> create /server data
> create -e /server/s1 192.168.0.2
上面常见了一个server目录,节点数据任意数据(这里用data表示任意数据),然后在其目录下创建一个临时节点,用参数-e表示,节点名字是s1, 数据是ip地址192.168.0.2。
如果会话链接还在,你在用zkCli 打开另外一个命令行窗口,控制台B,查看
>ls /server
[s1]
说明server下有s1节点,如果此时,你关闭了创建s1节点的会话窗口,
再次从控制台运行此命令
>ls /server
[]
发现s1节点已经被自动删除
通过命令create -s 创建带有序列号的节点,带有-s的create命令,会自动为节点增加一个序列号递增后缀,你可以通过这个判断节点创建的先后顺序
>create /task data
>create -s /task/t data
>create -s /task/t data2
先创建一个task节点,数据是任意数据,然后,在其节点下,创建一个序列节点,节点前缀是t,数据是任意数据,如果我们查看task下的节点,会有如下输出
>ls /task
[t0000000000, t0000000001]使用get命令 ,获取节点数据
>get /task
data
cZxid = 0x13
ctime = Fri Mar 24 15:52:09 CST 2017
mZxid = 0x13
mtime = Fri Mar 24 15:52:09 CST 2017
pZxid = 0x15
cversion = 2
dataVersion = 0
aclVersion = 0
ephemeralOwner = 0x0
dataLength = 4
numChildren = 2get操作第一行返回的是节点数据,其他行是节点的内部使用的数据,说明如下
| 属性 | 描述 |
|---|---|
| cZxid | 节点创建时的zxid |
| mZxid | 节点最新一次更新发生时的zxid |
| ctime | 节点创建时的时间戳 |
| mtime | 点最新一次更新发生时的时间戳 |
| dataVersion | 节点数据的更新次数 |
| cversion | 其子节点的更新次数 |
| aclVersion | 节点ACL(授权信息)的更新次数 |
| ephemeralOwner | 如果该节点为临时节点, ephemeralOwner值表示与该节点绑定的会话ID. 如果该节点不是临时节点, ephemeralOwner值为0 |
| dataLength | 节点数据的字节数 |
| numChildren | 子节点个数 |
这里zxid是一个顺序唯一id,长度为8字节,将在有状态服务分布式共识里说明
使用delete 删除节点
> delete /task/t0000000000领导节点选取
集群中的领导节点选取后,可以使用领导节点实现决策和资源分配功能,比如此领导节点能执行定时任务
可以使用命令行工具zkCli来演示如何完成分布式协调中的领导选取,稍后将使用curator API 完成
首先创建一个根节点,比如/election,此节点节点下集合了所有的候选者。然后,每一个候选者(每一个zk客户端)都是一个临时的,序列节点,如下
>create -s -e /election/e再用命令行工具zkCli打开多个窗口,模拟候选者,每个候选者都会调用上面的命令创建一个临时的序列节点。此时查看elecltion节点,可能看到如下候选者,
>ls /election
[e0000000004, e0000000003, e0000000002, e0000000001, e0000000000]
每个候选者使用zk创建一个节点的时候,都会知道自己创建的节点名,在选举过程中,用自己的节点名跟/election 目录下所有节点比较 ,如果自己的序列号就是最小的序列号。那自己就是当仁不让的领导者节点。
其他节点同时还需要watch 领导节点,即序列号最小的节点,如果领导节点被删除或者退出或者意外宕机,则所有候选者都会收到消息,则再次进行如上的选举过程。
这种选举过程比较简单,唯一的问题是如果有大量候选者,节点变化同时通知其他大量的候选者进行再次选举会对zk有一定性能影响,因此,一般改进的方式是每个候选者仅仅监听比自己序列号小的那个后选择。这样,如果领导节点被删除,则序列号较大的候选择能收到领导节点变化事件,只有他这一个节点完成选举过程,确认自己是领导节点。
Apache Curator 是Zookeeper的Java客户端库,并通过简单封装实现了分布式协调服务,集成curator,在pom添加如下依赖
<dependency>
    <groupId>org.apache.curator</groupId>
    <artifactId>curator-recipes</artifactId>
    <version>5.9.0</version>
    <scope>compile</scope>
</dependency>
连接ZK
RetryPolicy retryPolicy = new ExponentialBackoffRetry(1000, 3)
CuratorFramework client = CuratorFrameworkFactory.newClient(zookeeperConnectionString, retryPolicy);
client.start();
retryPolicy指的是连接策略为按照退避指数连接(TODO),这里的1000是基础等待时间为1秒,总共尝试3次
zookeeperConnectionString是zk集群的所有服务器地址,比如127.0.0.1:2181"
当如上代码执行完毕,即可以使用client操作zk,以及实现协调服务,比如在集群中确认领导节点
LeaderSelectorListener listener = new LeaderSelectorListenerAdapter() {
    public void takeLeadership(CuratorFramework client) throws Exception {
       //成为领导节点,如果方法返回,将放弃领导节点
    }
}

LeaderSelector selector = new LeaderSelector(client, "/election/e", listener);
selector.autoRequeue();  //释放领导权后,允许再次选取
selector.start();
分布式锁
分布式锁实现与领导节点实现方式类似,最小序列号的节点表示获得了分布式锁,其他节点监听比自己序列号小的节点
使用Curator如下代码实现
InterProcessMutex lock = new InterProcessMutex(client, "/somelock");
if (lock.acquire(maxWait, waitUnit)) {
    try {
        //被保护的资源
    } finally {
        lock.release();
    }
}
除了使用ZK实现分布锁外,还有通过Redis,etcd等高可用基础服务提供分布锁实现,也能采用数据库行锁实现。具体采用哪种分布式锁实现,需要考虑如下问题
| 特性 | 描述 |
|---|---|
| 可靠性 | 锁必须被一个进程持有,Redis由于主从数据异步复制方式,在主宕机情况下,其他进程连到从库,在数据未被同步到从的时刻也能获得锁,这样,有2个进程都认为自己获得锁。Postgres提供的advisory locks 也会因为主库故障导致多个进程可能获得锁。 |
| 公平性 | 期望锁在释放后,先等待锁的进程应该新获得锁。ZK总是为序列化最小的节点分配锁。 |
| 存活时间 | 如果锁因为系统自身故障等原因不能释放,其他试图获得锁的进程永远获取不了锁导致系统故障。因此分布式锁必须支持设定一定的存活时间 |
| 连接占用 | 应用系统在使用协调服务的时候,是否会占用连接资源?数据库提供的数据行锁或者其他锁功能,会占用数据库连接池而影响其他业务使用数据库连接。ZK和Redis实现锁不占用协调服务的链接资源。 |
| 吞吐量 | 如果有大量创建新锁的请求,比如每个订单一个锁,需要考虑协调服务是否能支撑。Redis由于支持分片因此其实现的分布锁能支持大并发量。ZK只有一个主节点提供分布式锁服务,其吞吐量较小 |