无状态高可用:ID、时钟和顺序
ID 是 Identifier的简称,用来唯一标识一个对象,如实体或者事件,可以是数字或者字符串,比如身份证号,设备ID,或者一个商品ID、订单ID等。分布式系统里,良好的设计习惯是总是对象赋予一个ID以及操作时间戳,有助于系统对此对象的查询,更新,跟踪。本节将介绍如何生成ID,下一节将介绍时间和时钟。
ID生成分为中心化分配、分布式生成,以及混合业务信息生成,最简单的方式利用中心化分配,通过单节点自增实现
| ID生成 | 描述 |
|---|---|
| 数据库自增ID | 可以使用MYSQL的AUTO_INCREMENT、或者Oracle的SEQUENCE |
| Zookeeper | Zookeeper提供了ZXID,一个Long类型的数据 |
| Redis | 如果使用Redis的INCR key,自增实现 |
从高可用角度来说,这种中心节点本身也是高可用的,比如Zookeeper通常有多个节点构成集群,ZK上的数据操作需要所有节点达成共识并存储。 数据库则依赖数据库的日志保证数据可靠存储。需要注意,这种中心化生成ID,在大并发请求下,因为要保证数据可靠存储,会有性能瓶颈
如果使用Redis的INCR key ,则需要谨慎,因为Redis 是内存数据库,为了极致性能,总是异步存储数据,因此并不能保证数据可靠的持久化。当Redis主节点宕机从节点接管,有可能产生重复的ID。
需要注意,由于数据库自增ID是连续的,容易被人预测到所有ID,比如用户信息接口
/user/101其他人容易预测到
/user/102并且,它通过递增来估算用户的总数。因此这种ID一般用于企业内部系统,很少暴露给外网。如果有这种必要,那必须做好数据权限功能,防止访问到无权限的数据
分布式ID通常使用时间戳、随机数、主机编号等信息混合生成,最常使用的是UUID。UUID 是俩个Long构成,总共16字节128bit。UUID通常以字符串形式体现,每4 bit用一个16进制字符代替,因此字符串总长度为32个, 以连字号分隔的五组来显示,形式为 8-4-4-4-12,共有36个字符(即32个英数字母和4个连字号)。例如
# v4版本
d2fe04d2-187f-4b19-ac76-206ff2737e88
# v7版本
01a0b382-65c4-73be-8bf7-d2d0dcb5ba16
# UUID通用格式
xxxxxxxx-xxxx-Mxxx-Nxxx-xxxxxxxxxxxx这里的M表示UUID的版本,占用4bit,N是变体,决定了UUID的构成,占用2bit。代表8、9、a、b中的一个。 UUID目前支持的版本如下
- 1 :表示UUID基于时间+Mac地址生成
- 2: DCE安全版本
- 3 :MD5命名空间
- 4: 随机数或伪随机生成的版本
- 5: 使用SHA-1哈希的版本
- 6 :时间重排版本
- 7: Unix 毫秒时间前缀+随机数
- 8:开发者自定义,必须保留版本号和变体字段,其他122bit由用户自定义实现
最常使用的是V4版本或者V7版本,前者生成一个无序的ID。 后者生成一个有序的36长度字符串。 UUID可以使用JDK自带的java.util.UUID类生成,或者使用开源库uuid-creator的UuidCreator,
//JDK
UUID uuid = UUID.randomUUID(); //v4
UUID uuid2 = UUID.ofEpochMillis(long epochMillis); //V7
//uuid-creator
UUID uuid = UuidCreator.getRandomBased(); //V4
UUID uuid2 = UuidCreator.getTimeOrderedEpoch(); //V7对于java.util.UUID的V4来说,俩个Long分别是mostSigBits和leastSigBits,均来自随机数, 源码如下:
public UUID(long mostSigBits, long leastSigBits) {
    this.mostSigBits = mostSigBits;
    this.leastSigBits = leastSigBits;
}
//或者私有构造函数
 private UUID(byte[] data) {
       //省略
 }
public static UUID randomUUID() {
    SecureRandom ng = Holder.numberGenerator;
    byte[] randomBytes = new byte[16];
    ng.nextBytes(randomBytes); /*从系统获取16字节随机数*/
    randomBytes[6] &= 0x0f; /* clear version */
    randomBytes[6] |= 0x40; /* set to version 4 */
    randomBytes[8] &= 0x3f; /* clear variant */
    randomBytes[8] |= 0x80; /* set to IETF variant */
    return new UUID(randomBytes); //构造UUID
}我们需要注意到ng.nextBytes(randomBytes);从系统获取一个16字节随机数,调用的是SecureRandom类,此类高并发下存在问题,基于UUID.randomUUID 将会出现性能瓶颈。
这是因为了获得真正的,难以预测的随机数,操作系统会 根据主机环境,如温度、网络数据包、磁盘读取、鼠标移动等预先生成一部分随机数,存放在 /dev/random 文件中。如果并发量大,则会导致随机数不足nextBytes 方法调用将被阻塞。
一种替代办法是使用非阻塞的种子文件,配置系统属性,随机数使用 uradom:
-Djava.security.egd=file:/dev/./urandom在数据库自增ID中,已经提到ID被预测,这种SecureRandom杜绝了生成的UUID被预测出来。 如果不涉及到敏感信息的ID,又想提升UUID的高并发,比如一个事件ID或者一个日志ID,可以使用伪随机数构造UUID代替使用SecureRandom,如下
// uid-creator提供了UuidCreator.getRandomBasedFast() 与下面代码类似
public static UUID nextUUID(){
    long mostSigBits = ThreadLocalRandom.current().nextLong();
    long leastSigBits = ThreadLocalRandom.current().nextLong();
    //忽略设置版本号等信息
    UUID uuid = new UUID(mostSigBits,leastSigBits);
    return uuid;
}UUID最为推荐的版本是V7,JDK26或者开源库uuid-creator提供实现。UUID V7的使用高位的 48bit作为UNIX时间戳(从1970年1月1日算起),以及剩余的74bit作为随机数(排除了版本和变体所占用bit),其格式为
TTTTTTTT-TTTT-7RRR-8RRR-RRRRRRRRRRRR这里的T代表时间,R代表随机数。字符7代表V7版本,字符8代表变体
需要注意,V7版本使用48 bit存储时间戳,因此最大毫秒数是 $$2^{48} -1 = 281474976710655 \text{ 毫秒$$,换算成年为可用8925年,从1970年1月1日算起,可以用到10895
在使用V7版本时候,或者其他任何基于时间戳的ID实现,必须考虑到时钟回拨,为了不影响V7的有序假定,所有实现在生成下一个ID的时候,会比较当前时间和上一次时间,如果存在时间回拨,则会使用上一次时间戳,随机数自增从而保持有序
lock.lock(); //同步
try {


    Instant now = instantFunction.get(); //得到一个Instant
    long lastTime = this.lastTime(); //上一次生成ID的时间戳
    long time = now.toEpochMilli();  //这一次时间戳

    // 获得一个最大时间
    if (advanceMax > Math.abs(lastTime - time)) {
       time = Math.max(lastTime, time);
    }
    //如果时间相等,则自增随机数,保持有序
    if (time == lastTime) {
       increment(now);
    } else {
       reset(now);
    }
    //生成UIID,msb和lsb为long。各自存放了8字节数据
    return new UUID(this.msb, this.lsb);

} finally {
    lock.unlock();
}
钟回拨可能是因为主机因为自身物理原因回调,或者与其他服务时间同步导致时间回调,这会影响系统基的有序性,有序是分布式系统的重要基础(TODO)
UUID的V4版本和V7版本,使用随机数会带来ID冲突(collisions),即不同节点可能生成一样的ID。尤其是使用伪随机数生成,或者成百上千的节点生成ID也可能导致重复,尽管这种概率很低,在实际使用UUID时候还需要遵守万一原则,尤其是超大规模集群和高并发场景, 需要做悲观设计
- 使用UUID在不重要的业务信息中,比如日志。
- 如果UUID持久化,建议使用唯一索引。比如使用UUID为订单主键,保证唯一索引。
- UUID和其他业务信息组合保证唯一性,比如订单使用UUID,建议联合用户ID作为唯一主键
有时候使用UUID的36字符过长,实际使用时候可以考虑去掉"-",变成32长度,进一步使用62进制代替原来的16进制,进一步缩减到22长度
public class UUIDUtil {

  final static char[] DIGIT = {
    'A', 'B', 'C', 'D', 'E', 'F', 'G', 'H', 'I', 'J',
    'K', 'L', 'M', 'N', 'O', 'P', 'Q', 'R', 'S', 'T',
    'U', 'V', 'W', 'X', 'Y', 'Z', 'a', 'b', 'c', 'd',
    'e', 'f', 'g', 'h', 'i', 'j', 'k', 'l', 'm', 'n',
    'o', 'p', 'q', 'r', 's', 't', 'u', 'v', 'w', 'x',
    'y', 'z', '0', '1', '2', '3', '4', '5', '6', '7',
    '8', '9'
  };

  final static int RADIX = DIGIT.length;

  /**
         * 将长整型数值转换为指62进制
         */
  public static String to62String(long i) {
    StringBuilder sb = new StringBuilder(32);
    while (i >= RADIX) {
      sb.append(DIGIT[(int) (i % RADIX)]);
      i = i / RADIX;
    }
    sb.append(DIGIT[(int) (i)]);
    return sb.reverse().toString();
  }

  public static String randomUUID(){
    UUID uuid = UUID.randomUUID();
    long most = Math.abs(uuid.getMostSignificantBits());
    long least = Math.abs(uuid.getLeastSignificantBits());
    StringBuilder sb24 = new StringBuilder();
    sb24.append(to62String(most)).append(to62String(least));
    return sb24.toString();
  }

  public static void main(String[] args) {
    //uuid为5a68630c-e3eb-46a7-a42e-63b44b753f45,压缩后HvOwXk8E95FH2ucMLPVC47
    System.out.println(randomUUID());

  }

}如果还有更短的ID字符串需求,建议使用数据库自增ID,其类型可以为8字节的Long或者4字节的Integer,如果4字节的Integer,可以满足Integer.MAX_VALUE个,考虑到使用62进制表示,则最短字符长度为1,最长字符串长度的是6。
System.out.println(to62String(Integer.MAX_VALUE));
//输出”CVUmlB“在UUID规范官网上,除了UUID本生说明外,也有对其他分布式ID生成有说明,比如较为流行的雪花算法。如果有兴趣,可以参考”其他分布式ID生成“
总结在分布式系统下,使用ID算法,需要关注如下几个需求:
| 特点 | 说明 |
|---|---|
| 是否有序 | 有序的ID有助于比较分布式系统先后发生的顺序事件或者请求的先后顺序,通常使用物理时钟或者逻辑时钟作为ID的一部分表达有序 |
| 是否会耗尽 | UUID V7可以高并发的使用接近万年。而使用数据库自增ID,则小的多,可以用作实体的ID,如用户,机构ID。本书未介绍的分布式ID雪花算法,因为使用年限较短未被推荐。Integer自增则会在使用超过Integer.MAX后耗尽 |
| 是否分布式ID | 分布式ID生成吞吐量较大,中心化分配的ID吞吐量较小 |
| 是否唯一 | 有些分布式ID算法并不能完全保证ID唯一,在一定条件下可能碰撞,需要设计兜底。有些算法,如雪花算法,包含了主机编号信息,生成的ID定唯一。但如果在不同主机上使用了同样的主机编号,则会出现重复,必须小心使用雪花算法。 |
| 是否可安全 | 伪随机数生成的UUID容易被预测出下一个UUID,有一定的安全风险。本书未提到的UUID V1,因为会暴露Mac地址而不被推荐使用。 |
| 是否较短 | 考虑到序列化性能,ID可读性等,有些业务场景需要较短的ID字符串,如短地址。 |
新的分布式ID算法,也是在这几个需求上做持续改善。
混合业务信息ID包含了业务信息,并附加上额外信息以防止ID重复,比如身份证号,如下是身份证的格式
18 位身份证号码 = 6 位地址码 + 8 位出生日期码 + 3 位顺序码 + 1 位校验码这里的顺序码是同一区县一天的出生人数,其中最后一位奇数代表男性,偶数代表女性。
校验码则通过特定算法前面17位进行运算取模获取。
有的ID则没有明显包含业务信息,而是业务信息通过低碰撞的HASH算法后再增加额外信息防止ID重复,比如产品密匙,设备ID的呢过,以设备ID为例子可以通过产品类型,申请日期等业务信息混合而成
deviceId = hash(产品类型+时间)这里的hash算法可以是xxh3、Murmur3等高速低碰撞算法,如下使用zero-allocation-hashing库提供的xx3
String salt="deviceInfo"; //加盐,防止被猜出来如何构造设备ID
//now返回一个当前时间yyyyMMddhhmmss
long hash = LongHashFunction.xx3().hashChars(salt+"冰箱"+now());
System.out.println(Long.toUnsignedString(hash,36));
//输出 3bf814xal5gbn
通常使用hash算法,返回8字节的long,相比于返回16字节俩个Long,仍然一定的碰撞概率,所以实际生成字符串形式的ID时候,可以考虑在增加一个字节用来防止重复。如上例子如果是批量生成ID,因为时间精确到秒,导致生成的ID可能重复。额外的一个字符可以递增或者随机形式出现,并依赖数据库做托底,类似防止UUID碰撞那样。
时钟和顺序
在分布式系统里,除了用ID标识事件外,事件所发生的时间非常重要,不仅仅通过时间用来查询事件和排序事件,也用时间实现TTL,租约等跟时间相关的操作,以及通过时间确定事件发生的先后顺序(另外一种是通过逻辑时钟,将在有状态高可用中说明)。比如:
- 计费事件总是带上一个时间戳,计费服务在任何时候都可以使用匹配此时间戳的计费策略进行计费。
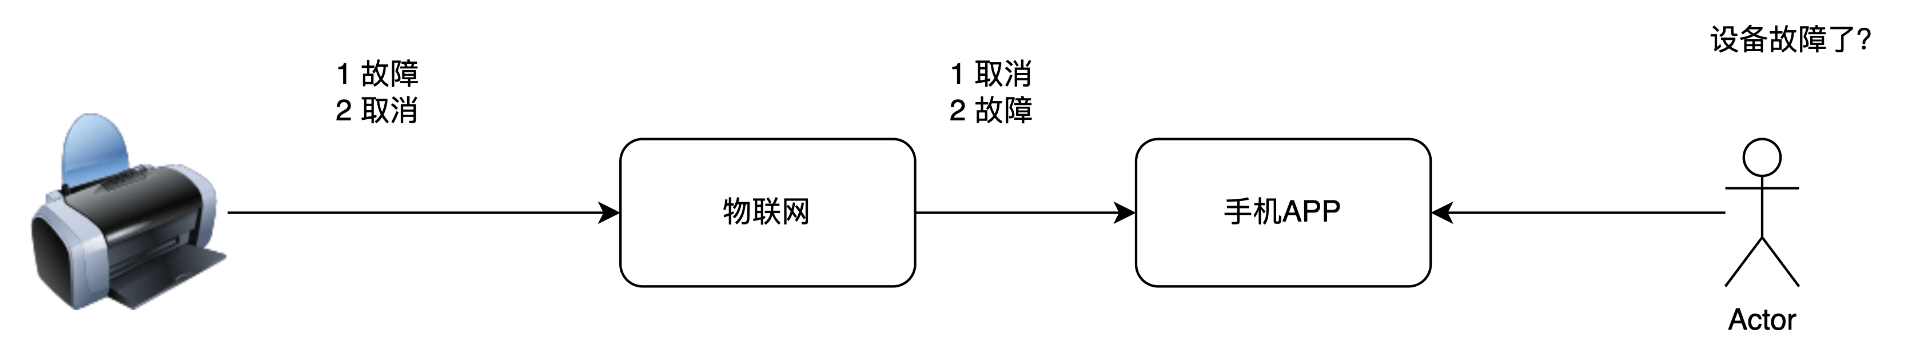
- 设备故障时发出了一个故障事件到物联网,当设备恢复后,紧接着发出一个故障取消事件。所有的事件自带一个设备的时间戳。
假设一下,如果设备的事件没有时间戳,会发生什么情况?比如“设备故障事件”发送到物联网系统,其内部包含了线程池,消息中间件等节点,或者在发送过程中因为某种节点故障导致事件重发,会导致后发的“故障取消事件”先到APP端, 而“故障事件”未到。如果不带上时间戳,手机APP按照顺序处理,处理后App显示的是设备故障。
在分布式系统里,为事件带上时间戳是一个最佳实践,那么如何获得时间戳?最简单的方式是调用计算机操作系统API获得物理时钟,所有的计算机都包含了一个计时器的硬件,通常是石英晶体振荡器,支持毫秒级产生一次中断通知计算机。每次中断都会让操作系统计算增加1。系统在初始化时候必须首先设置一个时间。这种计时方式称为物理时钟或者日历时钟(wall clock),如下Java代码获取到当前时间戳
//wall clock
System.currentTimeMillis()
需要注意的是,通过石英晶体振荡器获得时间的的方式都会出现时间回拨的情况,即有可能再次调用获得的时间小于上一次调用获取的时间。
对于硬件定时器来说,它可能是因为自身物理设备稳定性原因,或者是因为节点需要与时间服务器(NTP Server)校正时间,导致时间回拨。比如此刻是17:00:00, 下一刻时间变成16:59:59。时间回拨也可能因为虚拟机漂移导致时间看起来回拨
时间服务器: 对外提供时间同步服务的服务器,服务器从 GPS 接收器等更精确的时间源取得时间。客户端查询时间服务器获得并校正本机系统的时钟。
我们在uuid-creator的V7的实现中,为了保证uuid的有序性,会比较上一次时间戳和当前时间戳,如果出现时间回拨,则uuid的时间值部分保持上一次时间戳,随机数部分则递增以实现有序。
在业务系统里,为那些时间顺序敏感的事件添加一个时间戳,也需要考虑到时间回拨,比如,下面代码片段展示总是提供一个有序时间的方法
static long lastTime = getTime();
public synchronized  long now(){
    long now = getTime()
    if(now>=lastTime){
        return now;
    }
    Thread.sleep(lastTime-now);
    return now();

}
public static long getTime(){
    return System.currentTimeMillis();
}
除了处理了时间回拨,还可以使用递增顺序号表示事件发生的先后顺序:
- 设备向物联网发送的事件带上顺序号,比如故障事件的seq=1,故障恢复事件seq=2;物联网如果已经处理了seq=2的事件,那将忽略seq=1的事件
- 蓝牙Mesh网络中,节点的Seq字段用于记录命令的顺序号,下游收到命令后,通过此Seq判定是否收到重复命令。
- TCP协议中,网络路由不同,数据包到达顺序不同,可以使用的Sequence Number,用于确定数据包的顺序。比如对1~1460 字节包指定seq=1,1461~1540字节包指定seq=2,如果接收方先收到seq=2,则缓存数据,等待seq=1的包到达
上述都是单节点使用顺序号代替时钟表示先后顺序,在很多场景下,需要考虑到多节点事件发生的先后顺序,比如多人在线编辑并合并文档、多人聊天消息同步、分布式文件系统或者数据库的事务提交,这将使用逻辑时钟以及向量时钟实现。这将在有状态高可用战术中简要介绍。