有状态高可用:分区和分区扩容
如果系统只有一个有状态服务节点,会有如下问题
- 单节点存储的有状态数据总量是有限的。
- 单节点也带来了系统的不可靠性,单节点宕机或者维护将导致系统不可用
- 单节点访问性能是有限制。
解决这些的问题的方法是使用分区,每个分区保存一部分数据。有状态服务的分区设计,跟NOSQL 采用的分区设计是一样的。想象分区在一个城市的教育系统的应用场景,城市里如果只有一个中学,那么所有的学生都将在这个学校读书。如果人口增长,那么这个学校,交通等等必然不堪重负。这个时候最好的办法是多建几所学校,城市的每个地区拥有一所学校,学生按照就所在城区选择学校。
有状态服务如何将数据分区,依赖于将如何使用这些数据,比如学校可以按照区域划分,英文词汇可以按照字典那样,按照首字母进行分区,如果缓存文档的有状态服务,可以按照文档的标题的首字母进行分区,如下例子,用户查询abandon,客户端查询存放a字母的的分区1
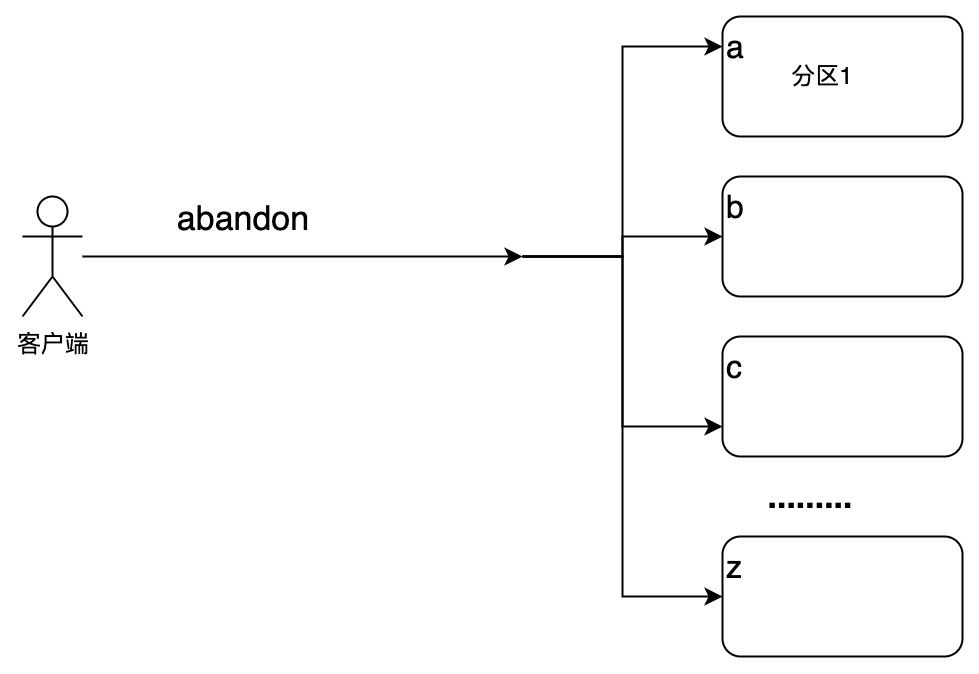
这种分区方简单直观,需要客户端了解分区规则,比如分区规则是字母a开头的单词在分区1。 更常用的方式是
使用代理,如下图那样,代理知道分区规则,因此能把字母a开头的查询路由到分区1. 如果分区规则发生了改变,比如将a和z开头单词较少,可以合并到一个分区;或者字母c单词较多,分区拆分成cj和cm俩个分区,前者包含了cj之前的单词,后者分区包含了cm之后的单词。代理仍然能正确路由而不需要客户端调整
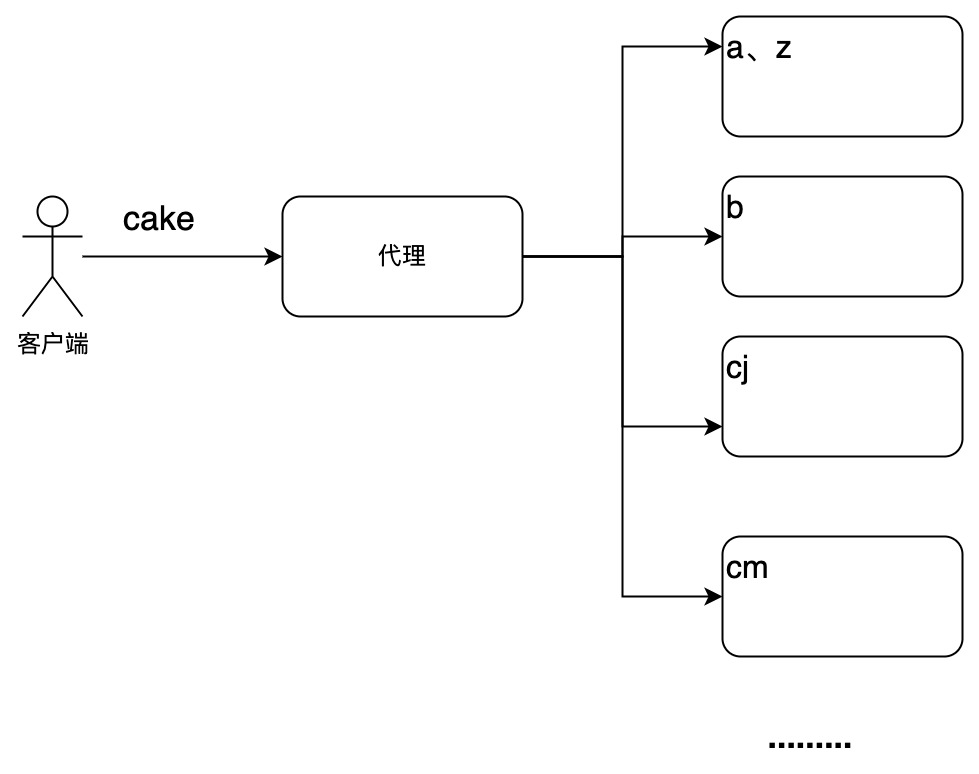
还有几种查询方式,比如客户端可以查询任何分区,分区包含了路由规则,因此可以将查询转发到正确的分区。 或者提供一个资源服务用于查询单词所在分区。可以参考负载均衡了解如何实现路由。对于物联网来说,设备将固定连接到某个分区(一个设备网关实例)
需要注意的是,一个或者多个分区会部署在一个物理节点上,比如可以将a和z分区部署在一个2C服务器上,而c分区部署在一个8C服务器上,需要记录分区到物理节点的映射,分区规则,节点信息等这些分区元信息,分区元信息必须能可靠的保存以及能被客户端或者代理网关高速查询,元数据可以保存在数据库中,或者ZK,etcd这样支持配置服务的中间件。像Kafka,Cassandra使用Zookeeper保存分区信息,Kubernetes使用了etcd记录每个服务运行的实力位置。这些服务自身也属于有状态服,也是本章的的范围。
最好的分区方案,应该满足如下特性:
- 分区数据均匀,如上例子,按照首字母分区显然很难让数据分区均匀。通常使用HASH算法来均匀分配有状态数据,本节剩下部分将重点介绍
- 分区能方便扩容缩容,如上例子,一开始就规定了分区个数从a到z,允许未来将分区进一步拆分,比如c字母开头的拆分成cj和cm俩个分区。扩容缩容涉及到分区中的数据迁移,通常导分区数据不平衡,以及可能服务暂停记性分区之间的数据复制。下一节将介绍这部分内容
- 分区元信息记录了分区规则和分区对应节点的状态,必须有可靠系统实现分区元数据管理。本章在《复制》和《共识》章节将说明这些服务如何实现高可靠,高性能。有状态服务的难点和重点即复制和共识。
无状态节点服务,代理通常使用随机方式实现负载均衡,但对于有状态服务,则不能像无状态服务那样随机分配请求,因为有状态服务每次查询,都需要粘性链接到相应的数据节点。因此普遍采用Hash算法,使得客户端固定连接到某一个分区。如下下例子中,根据文档的标题来确定读写的节点
long partionId = hash(title)%N;
int nodeId = mappping(partionId)
这里的N代表分区总数,hash算法是将目标字符串换算成一个整数,最常见的是,CRC16,MD5或者Murmur哈希等,它可以将任意长度的byte[] 转换为哈希值. 然后通过分区总数取余,计算出分区Id。 分区id指向一个物理的节点nodeId。比如,一个物理节点只有一个分区,那么
int nodeId = partionId;建议不要使用Java语言内置的Hash算法,比如Java的Object.hashCode。这样可能无可能导致跨平台使用
如下图所示,系统共有俩个节点,假设规划数据为2个分区,则每个分区存放在一个节点上
| Key | Murmur hash 值 | 分区Id=Math.floorMod(hash,mod) | nodeId |
|---|---|---|---|
| hello | -1283840835669994617 | 1 | 1 |
| world | 556622672101494404 | 0 | 0 |
如果规划系统有8个分区,节点仍然只有2个. 每个节点负责俩个分区
| 分区 | 映射到节点 |
|---|---|
| 0 | 0 |
| 1 | 0 |
| 2 | 0 |
| 3 | 0 |
| 4 | 1 |
| 5 | 1 |
| 6 | 1 |
| 7 | 1 |
那么如下Key所在节点:
| Key | Murmur hash | 分区Id=Math.floorMod(hash,mod) | nodeId |
|---|---|---|---|
| hello | -1283840835669994617 | 7 | 1 |
| world | 55662267210149440423 | 4 | 1 |
| good | -2592531913143520475 | 2 | 0 |
当数据量增加,需要扩容节点时候,可以将一些分区分配到新增节点。比如新增一个节点2,如上分区映射关系调整成如下
| 分区 | 映射到节点 |
|---|---|
| 0 | 0 |
| 1 | 0 |
| 2 | 0 |
| 3 | 2 |
| 4 | 1 |
| 5 | 1 |
| 6 | 1 |
| 7 | 2 |
这样,新增节点2 负责分区数据是分区2和分区6。这俩个分区的数据需要复制到新的节点2,其他分区的数据则不需要调整,如上的“hello"和"world"数据仍然分别保存在节点1上。数据"good" 由于在分区2上,需要迁移到节点2上
这里注意到节点2仅负责俩个分区的数据,这造成了服务负载不均衡。下一节介绍由于扩容缩容造成的分区不平衡
实际分布式系统中,都会采用一个较大的固定分区数。然后配置分区与物理节点映射关系,当物理节点变化时候,只需要调整分区和物理节点映射关系,而不需要调整客户端
下面是常用的中间件默认分区数,建议有状态服务也设置较大的分区数,10倍于物理节点数目.
| 中间件 | 分区数 |
|---|---|
| Redis | 规定为固定值16384 |
| Kafka | 单个TOPIC不超过1024分区,常规业务建议10-100个。 |
| Hazelcast | 固定位271个分区数目 |
| cassandra | 依赖物理节点数目决定,默认一个物理节点占据16个虚拟分区。 |
| Elastic Search | 每个索引自定义分区数。 |
需要注意,每种中间件有自己分区设置建议,以Kafka为例子,Topic中的每个Consumer消费一个分区,如果分区数设置过小,则只有较少的Consumer,影响消息消费的吞吐量。如果设置分区过大,分区元数据存储和管理成本增加。
ES较大分区能增加能提高索引查询速度,但涉及到分组聚合查询,需要查询所有分片性能降低。
对于有状态服务来说,使用一致性HASH算法,它实现如上类似分区到节点的映射,当节点变化的时候,少量分区重新映射到新的节点上。大部分区的映射关系保持不变。注意:如果新节点上这些分区没有数据或者数据还未复制到新节点分区上,则查询数据会失败
一致性HASH算法主要有7种算法,最早的有是1997年由David Karger等人提出的一致性HASH环,后续后还有来自Google对的 Maglev算法。其他算法还有Rendezvous,Jump,Multi-probe,Anchor,Dx。 衡量一致性HASH算法的主要指标如下
| 指标 | 说明 | Maglev | HASH环 |
|---|---|---|---|
| 均衡性 | 指的是Key能均匀分布在各个节点,作为衡量一致性算法的核心性能指标 | 非常均衡 | 均衡 |
| 查询性能 | 衡量对象映射到节点的速率,作为衡量一致性算法的核心性能指标 | 快,O (1) 查表 | 慢 O (log M) 二分查找 |
| 更新节点的性能 | 当节点增加和减少时候,一致性HASH算法需要重建分区映射的时间 | 慢 | 快 |
| 内存占用量 | 实现一致性HASH需要占用的内存 | 高 | 低 |
以某物联网的例子,模拟1百万的的设备,分布在500个网关分区上,平均每个分区点2000设备。使用Maglev算法,2000个分区,设备数量分布在各个分区上的差值小于100个,非常均衡。而使用HASH环,分区上的设备数目差值小于400个
10.3 分区扩缩容
随着有状态服务的运行,有各种原因可能会导致分区的负载不平衡,即有的节点负载较大,有的节点负载小,常见情况是分区上包含热点数据,如家电物联网,热水器类的设备因为频繁上报温度和告警,导致所在设备网关负载较高。本节介绍了分区扩容过程中以及扩容后需要注意的事项。
当考虑有状态节点扩容时候,在集群里新增若干节点,高负载节点的负载可能不会立即下降,这是因为节点扩容后,分片数据会完全复制成功,新的节点才能提供使用。如果源节点上数据更新频繁,使得这种复制时间较长,新节点无法立即投入使用。
下图展示了4个分片2个节点架构的有状态服务,当新增节点3时候,需分片1的数据完全复制到新节点才能停用节点1的分片1数据。这需要一个较长的时间。状态服务中间件不必停止对旧分片1的访问,可以一边复制数据到新节点上,一边把后续的数据改变记录成日志,等待在新分片上重新执行。关于数据的复制,将在10.6中说明
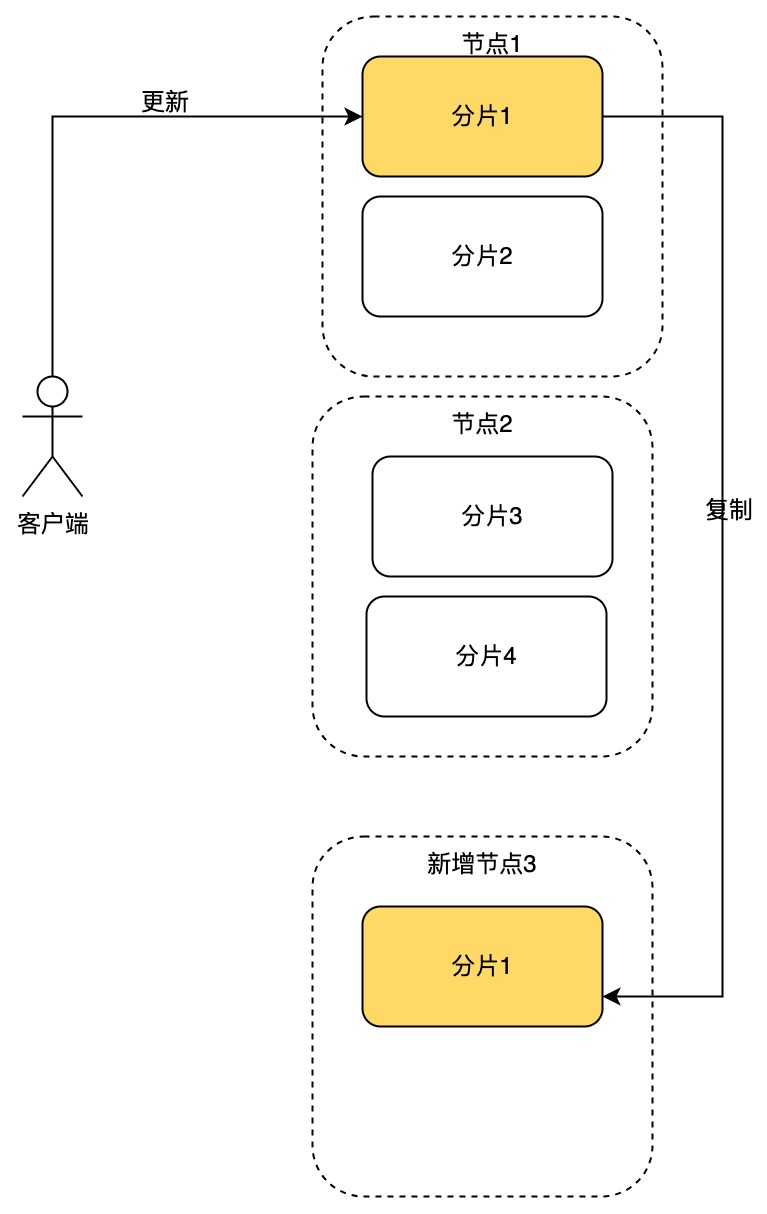
如果新旧分片允许同时被访问,则有可能产生数据不一致的情况,比如客户端修改了旧分片的数据,然后紧接着访问新分片数据,此时数据可能还未同步到新分片。
Kafka新增分区时候,也有类似数据不一致问题,比如Consumer消费了旧分区的数据且还未提交。如果此时新分区被指派给这个Consumer,可能Consumer还可能再次消费同样的消息。如果涉及到关键业务,需要做好幂等。
在一个物联网的影子系统,使用128分片的Redis。后期扩容成256分片,运维当时给出的估计是影子系统(客户端)不需要停机,且认为几分钟内就能扩容成功。但实际上花了半小时都未能库容成功,这是因为影子系统记录的是属性上报,典型的写多的场景,在1个分片数据被拆分到俩个分片并复制的时候,一直有持续的数据更新记录在产生。最后团队不得不停止影子服务,扩容在1分钟内就成功
因此,当你使用Redis等支持分片的NOSQL时候,你需要与运维沟通,从扩容开始到成功期间,需要多长时间,是否需要停止客户端服务,以及如果不停止服务,会不会产生数据不一致情况。
即使扩容成功,如果简单使用一致性HASH路由策略,有状态服务在进行扩容后,原有流量几乎流向原有的节点,新增节点流量长期较低,高负载流节点会数天,数周都无法缓。下图新增分片100,但因为一致性HASH的原因,绝大部分流量还在原有分片上,新增分片流量较少。
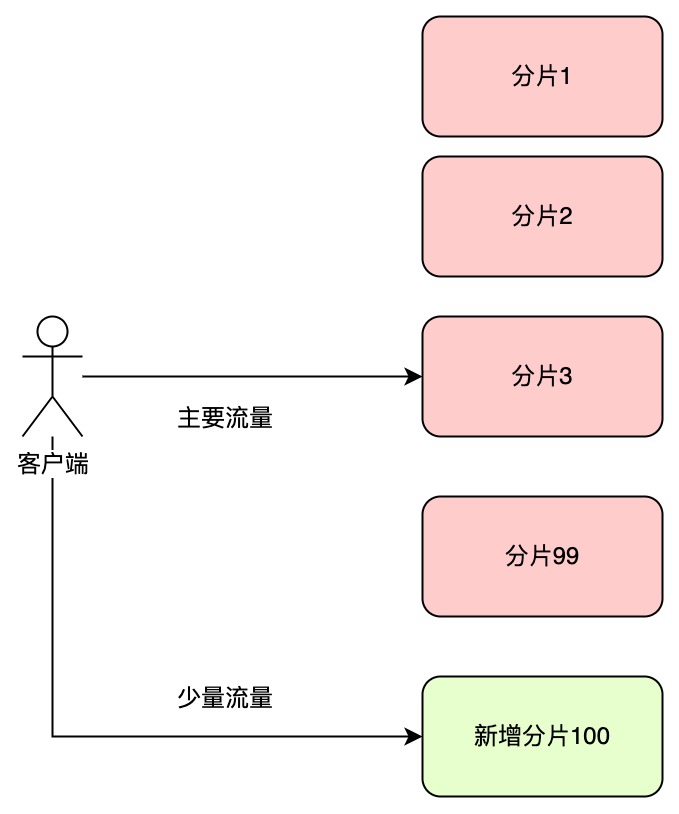
产生分区不均衡的原因还有可能是分片到节点的映射关系在上一节中的,节点数目是2,分区数目是8. 当新增节点2后,新节点2得到了2个分区的数据,而其他节点有3个分区的数据,造成了节点2的访问量较少
| 分区编号 | 原有2节点 | 变成3节点 |
|---|---|---|
| 0 | 0 | 0 |
| 1 | 0 | 0 |
| 2 | 0 | 0 |
| 3 | 0 | 2 |
| 4 | 1 | 1 |
| 5 | 1 | 1 |
| 6 | 1 | 1 |
| 7 | 1 | 2 |
解决扩容导致的分区不平衡,最简单办法是成倍扩容,比如1个节点扩容成2个节点,这样每个节点拥有原来节点一半分区的数据。阿里云的Redis集群,扩容办法采用了类似的策略。将节点数目增加一倍。只支持扩容方式是2,4,8,16,32,64,256,512,1024 个分片。当需要扩容的时候,节点按照原有分片增加一倍。
以2个节点为例子,
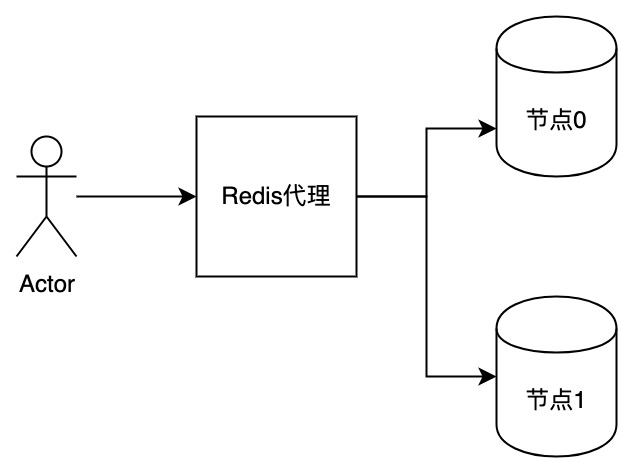
扩容后,旧节点的数据复制到新增的节点,节点0的部分数据复制到节点2,节点1的数据复制到节点3
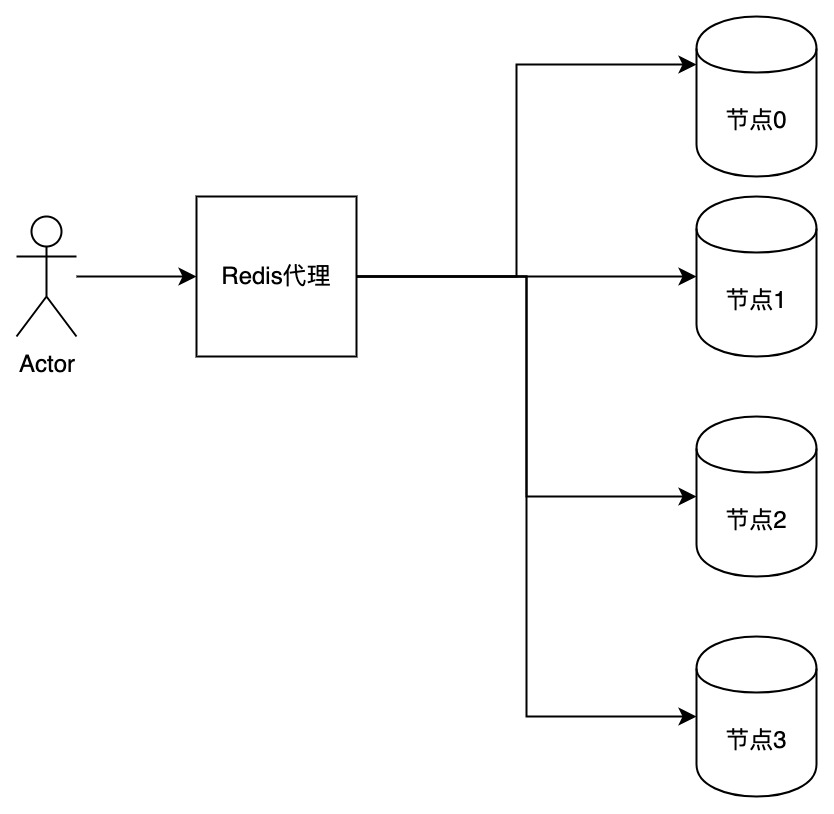
这种扩容能解决分区不平衡。缺点是需要投入成倍的硬件资源。对于有状态服务,或者类似的NOSQL来说,扩容通常是新增少量节点以节约成本。因此,最常用办法包括如下4种(TODO,看看其他NOSQL的平衡策略)
| 方法 | 描述 |
|---|---|
| 尽早扩容 | 在节点负载过高告警之前就尽早进行扩容,通过运行一段时间流量逐渐平衡。如果流量告警再扩容,新增节点因为分配不到流量而不可能缓解负载过高问题 |
| 高负载Key迁移 | 对于热点数据,可以迁移到专门的有状态服务集群。比如热点微博,或者上列中的物联网中热水器(需要处理较多属性上报和告警) |
| 重定向 | 节点通知客户端重定向,客户端可以获取到低负载的节点地址,重定向也适合让客户端获取到原有数据新的分区地址,比如 Redis 支持MOVED转向 |
| 临时路由策略 | 扩容后,新的客户端(包括通知重连的客户端)依据负载来选择有状态节点,而不是通过一致性HASH,直到流量平衡后,路由策略再切换到一致性HASH。新节点部署时候,节点应该优先路由到这些节点。 |
无论采用什么策略进行负载再均衡,都需要具备一个流量监控系统,监控节点负载情况,以及连接节点的客户端个数等监控。当出现不平衡时候,需要运维人决定采取既定方案进行再平衡。