有状态高可用:复制
复制
复制是将主节点的数据从一个节点复制到另外一个或者多个节点,复制是分布式系统的最核心技术之一,无论你的系统是有状态服务,还是像Kafka,Redis那样的中间件,或者是Zookeeper,ETCD协调服务,还是SQL和NOSQL数据库,复制是这些系统高可靠,故障可恢复的基石,也是最难的技术点。
状态数据复制到其他节点,主要有如下作用:
- 系统发生故障,状态数据仍然存在其他节点,能继续提供服务。
- 提供更高的吞吐量,其他节点可以提供高并发,高流量的查询。
- 数据复制到其他机房,地理位置能接近用户,降低访问延迟。
- 复制的节点提供不同数据引擎。比如在tidb中,主节点和从节点分别支持OLTP和OLAP。提供混合事务分析能力HTAP
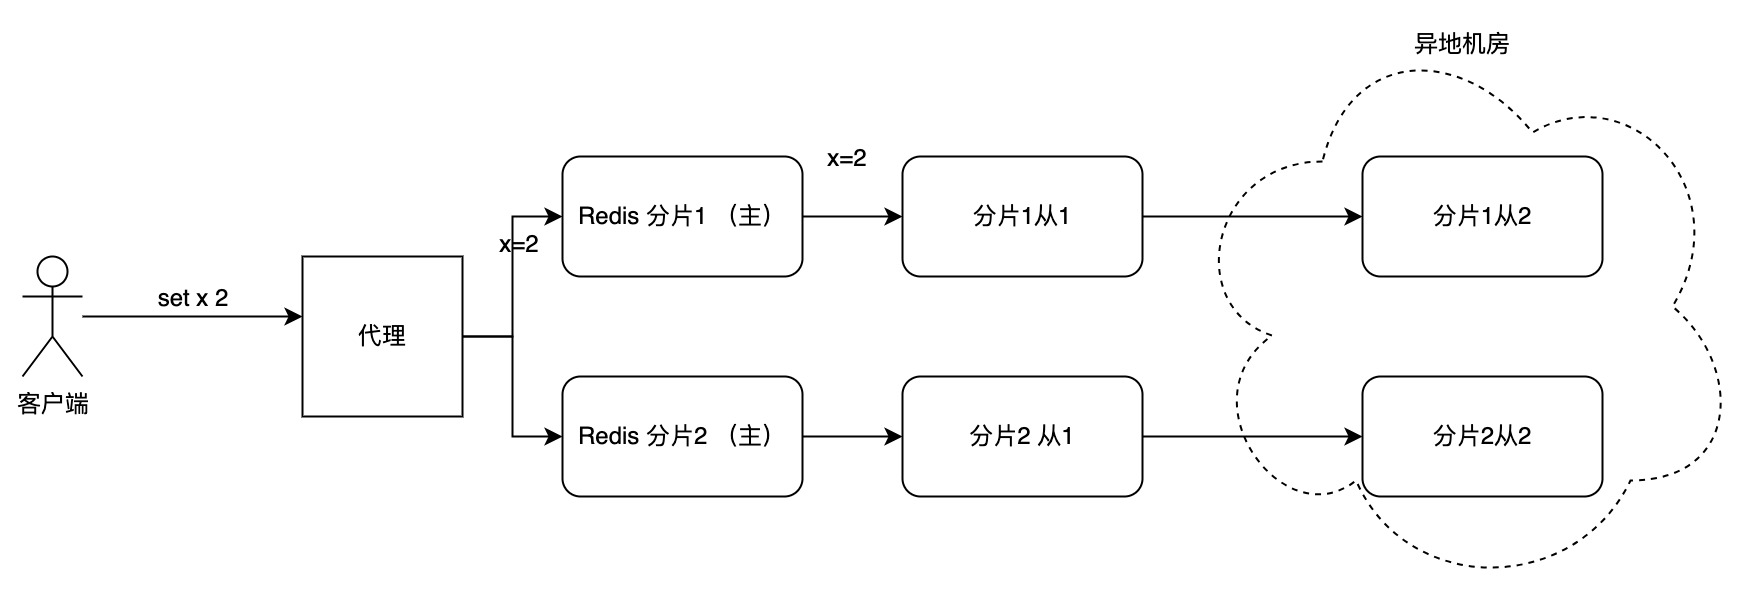
下图展示了一个Redis,一主多从的2分片架构,Redis的主节点数据复制到从节点。当主节点不可用(故障或者升级),从节点将继续提供服务
下面命令行是Kafka创建名为device-attribute Topic时候,指定了4个分区,每个分区有3份数据,即数据将额外再复制3份数据到其他节点
kafka-topics.sh --create
--topic device-attribute  --partitions 4
 --replication-factor 3
 --bootstrap-server localhost:9092
关于复制,有许多关键主题需要探讨,本书将覆盖这些主题,并讨论这些主题对服务节点影响,以及客户端影响。下一节将提供一个数据引擎LSM-Tree的复制实现。 由于篇幅有限,每个主题不会深入描述细节,如果关心这些细节,可以进一步从NOSQL,数据库等实现中获取这些知识。
本书只涉及单主复制或者基于领导者(Leader-based)的副本机制。即只有一个主节点负责接收写,并将数据复制到从节点。从节点不会接受数据变更操作。与单主复制对应的有多主复制和无主复制,不在本书的范围。
10.5.1 同步还是异步
当主节点采用同步方式复制数据时候,需要等待从节点的响应,响应成功后才能给予客户端确认。同步复制保证了数据一定复制成功,但会影响客户端性能。与同步复制相反,如果主节点使用异步复制,则不需要从节点应当数据保存是否成功,直接返回客户端,客户端高吞吐量和低延迟。
大多数有状态服务,NOSQL,中间件都同时支持同步或者异步复制,并默认采用采用异步复制以提高吞吐量,如果客户端选择读取从节点,则因为异步原因,有可能未能读取到数据,即使自己写到主节点的数据,然后立刻再读取,客户也可能发现数据读取不到(称为Read-your-writes,写后读一致性)。
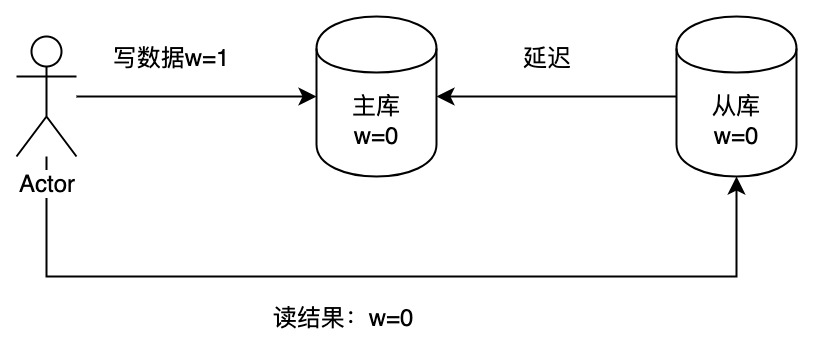
如下是一个MYSQL或者其他任何主从架构的产品,假设w=0,当客户端写w=1,设置如果客户端连接从库查询数据,由于从库有延迟,则可能造成数据不一致,客户端读取到的数据还是w=0
有的中间件提供显示的选择,比如Kafka,当生产消息时候,允许设置acks值
- acks为0:告诉Broker,不必等待主分区操作完毕,即回复。这样的参数配置保证了生产者高吞吐量和低延迟。 如果Kafka的Broker没有收到数据或者没有保存到磁盘,数据丢失
- ack为1:告诉Broker,数据保存到主分区再回复生产者,不必等待其他分区同步完成。如果过主分区故障,有可能丢失数据
- ack为all,告诉broker,数据主节点保存,并同步到所有在ISR(那些符合特定延迟条件的从节点)列表的节点后,再回复生成者成功。
Zookeeper 采用同步复制,并达成大半数共识认为复制成功,客户端仍然有可能连接到其他从节点读取还未更新的数据,不过Zookeeper允许客户在读取数据时候,客户端提供显示标记sync。zookeeper识别此标记等待所有从节点数据同步后,再返回给客户端。
如果你访问mysql这样的主从库,DAO可以检测事务如果是只读事务,可以返回从库。如果不是(表示混合读写操作),让客户端直接操作主库。如下是BeetlSQL框架访问主从库的配置,如果BeetlSQL判断是是一个事物写操作,那么事物内的所有数据库访问,无论读写都访问主库。
//如果是更新语句或者是分读事务,返回主库
public Connection getConn(ExecuteContext ctx, boolean isUpdate){
    if (isUpdate){
        return this.getWriteConn(ctx);
    }

    //在事物里都用master,除了readonly事物,调用者可以显示的使用@Transactional(readOnly = true)
    boolean inTrans = TransactionSynchronizationManager.isActualTransactionActive();
    if (inTrans) {
        boolean isReadOnly = TransactionSynchronizationManager
            .isCurrentTransactionReadOnly();
        if (!isReadOnly) {
           return this.getWriteConn(ctx);
        }
    }
}
如下俩个方法,getById访问从库,而updateName访问主库
//只走从库
@Transactional(readOnly = true)
public User getById(Long id) {
    return userMapper.selectById(id);
}

// 普通写事务,查询和更新都是主库
@Transactional
public void updateName(Long id, String name) {
    userMapper.updateName(id, name);
    User user = userMapper.findById(id);

}
如果主从库延迟较长,则客户端发起的再查询,可能仍然看不到从主库更新的数据,因此需要记录上一次客户端的更新数据库数据的时间,设定1分钟内的任何操作,定位到主库。这个记录可以放到Cookie里。
你可能觉得数据库或者中间件应该屏蔽这种主从选择而不需要客户端去选择主从库访问,这里列举出使用ORM工具来屏蔽,但仍然需要客户端提供信息,比如事务是否是读事务,以及Cookie记录等。这再次说明高可用需要端到端实现。
10.5.2 Pull 还是 Push
当实现状态数据复制的时候,可以选择主节点主动推送数据,或者是从节点从主节点拉取数据。
- 当采用主节点推送push方式,其优点是实时性强,缺点是从节点容易过载(背压)。
- 当采用pull方式,和push方式相反,实时性差点,但灵活性高,从节点可以依据其负载能力获取数据。Kafka的从节点采用pull方式从主节点复制数据(kafka的消费者采用的pull方式,定时从Broker 拿去消息)。
zookeeper主从节点则采用同步方式,除了数据陈工保存在主节点外,确保其他一半节点数据保存成功后再返回客户端,下图,当客户端写数据"hello"到/data 节点,主节点先在本地缓存区保存,然后分别调用从节点zk2和zk3,当zk2和zk3任意节点返回成功后,主节点将执行commit操作,把缓冲区的存储的数据存储到磁盘上并返回成功相应到客户端
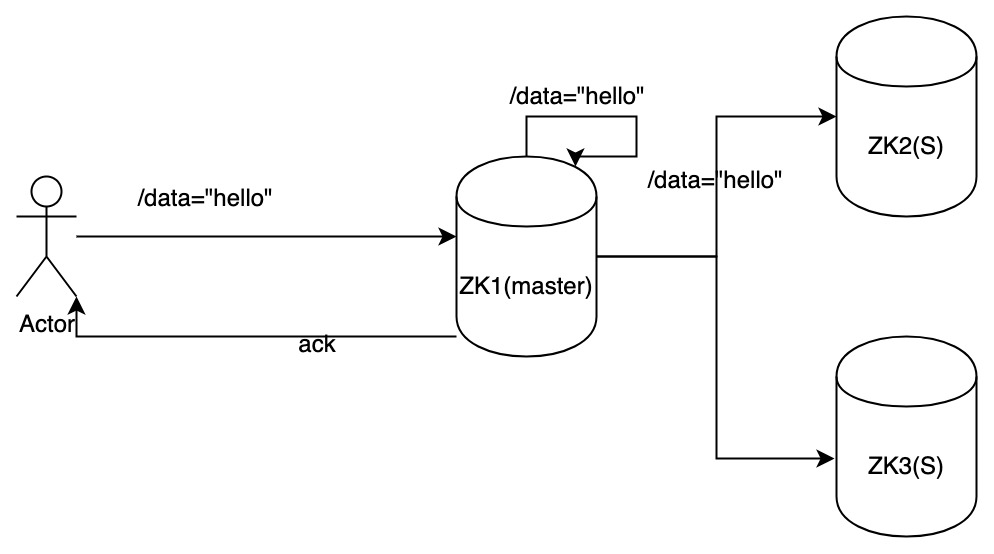
Zookeeper之所以并没有等待所有从节点返回,是因为只要超过一半的节点保存数据,即可以认为数据保存成功,不需要等待所有节点回复。 关于这一部分内容,将在10.8 一致性共识 说明。
在从节点初始连接主节点的时候,从节点需要将自身的已经复制的数据进展告诉主节点,主节点将剩下的数据传回给从节点。 当从节点数据赶上主节点的数据时候,从节点就可以开放给客户端提供服务。
以Redis为例子,从节点复制数据的过程如下
- 连接主节点,并将自生数据的复制进展告诉主节点,这里的进展使用数据流offset表示,主从节点各自维护。
- 如果从节点是首次连接,offset是-1.。主节点将生成一份快照响应从节点。称为全量同步(Full Synchronization)
- 如果是因为从节点断开后缺少数据,需要执行部分同步的操作。主节点判断如果缺少过多的数据,将仍然响应一份快照,从节点清空数据使用最新的快照恢复数据。
- 如果从节点断开后从连,或者全量同步后,会再次携带offset请求主节点,如果offset指向的数据在主节点Redis命令缓冲区内数据,从节点将pull到命令缓冲区的数据,成为半同步(Partial Resynchronization)
- 从节点状态可用,后续主节点将PUSH数据到从节点。
10.5.3 拓扑
当主节点有多个从节点的时候,这些节点是从主同步数据,还是依次从上一个从节点同步数据?
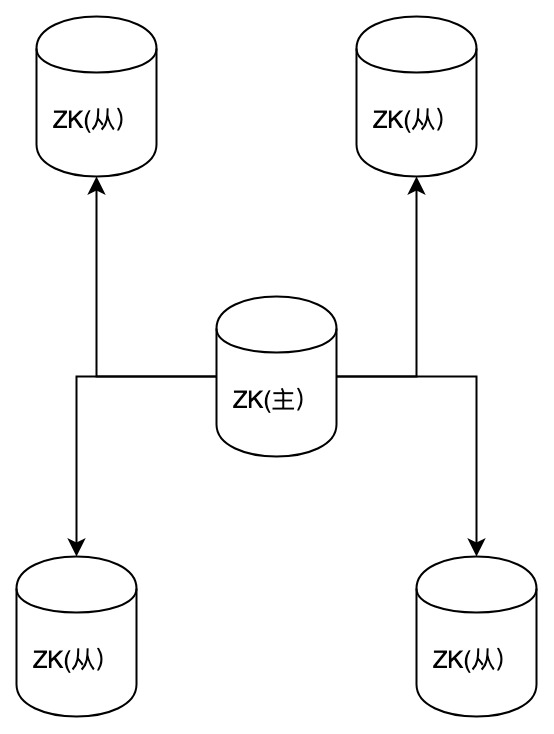
Zookeeper的主从节点采用的是星行拓扑,所有从节点的数据来自主节点。如下图,当主节点收到数据更改命令,将发给所有从节点,如果有超过一半的节点(包括主节点自身)允许更改。znode数据将更新并持久化到磁盘、
Redis主从拓扑通常采用串行结构,以避免同步数据对主节点影响。尤其是异地机房网络。 如下图Redis 的主从拓扑结构。这样的好处是复制对主节点影响最小。
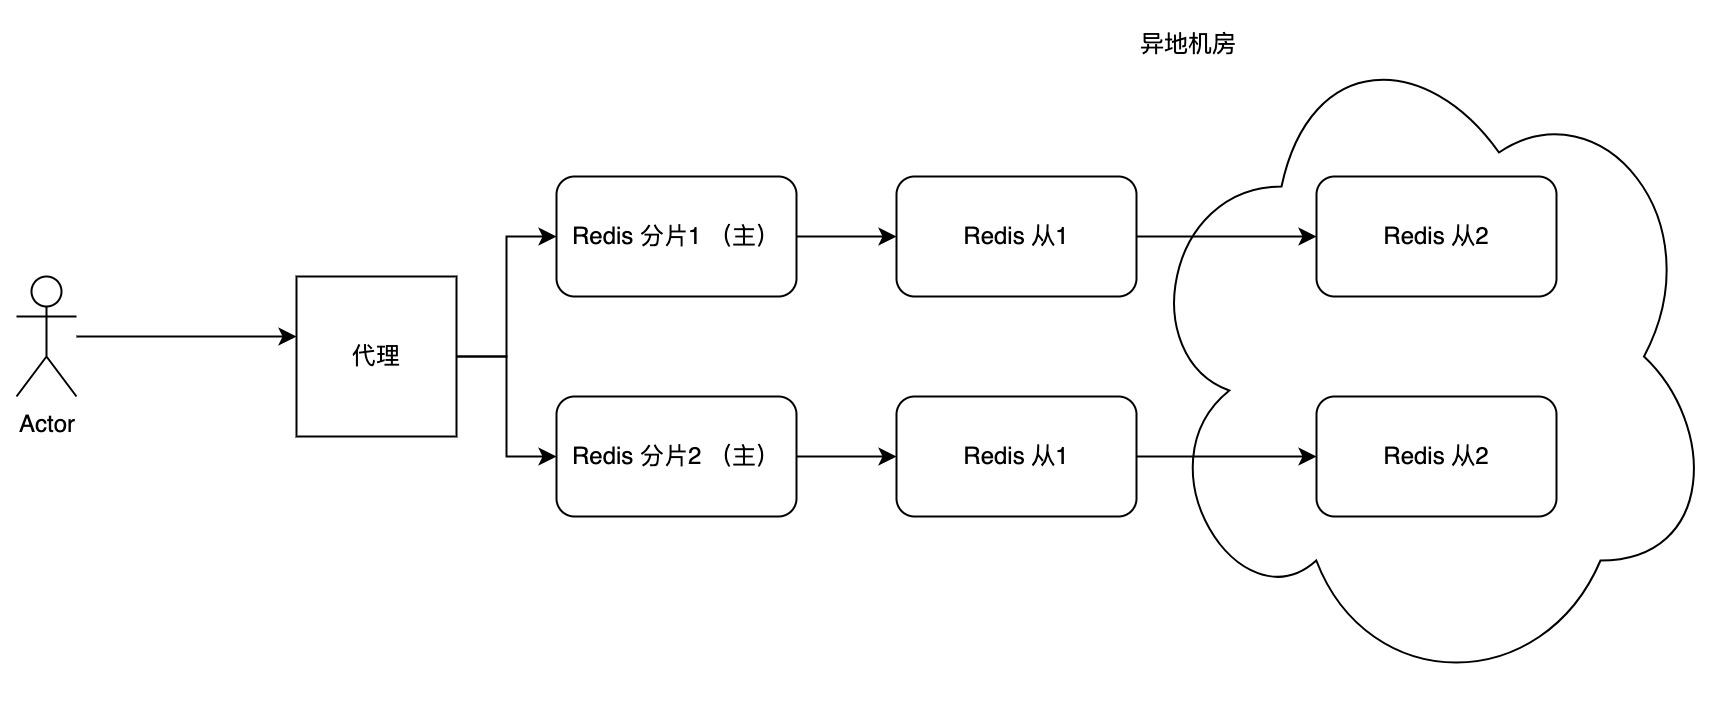
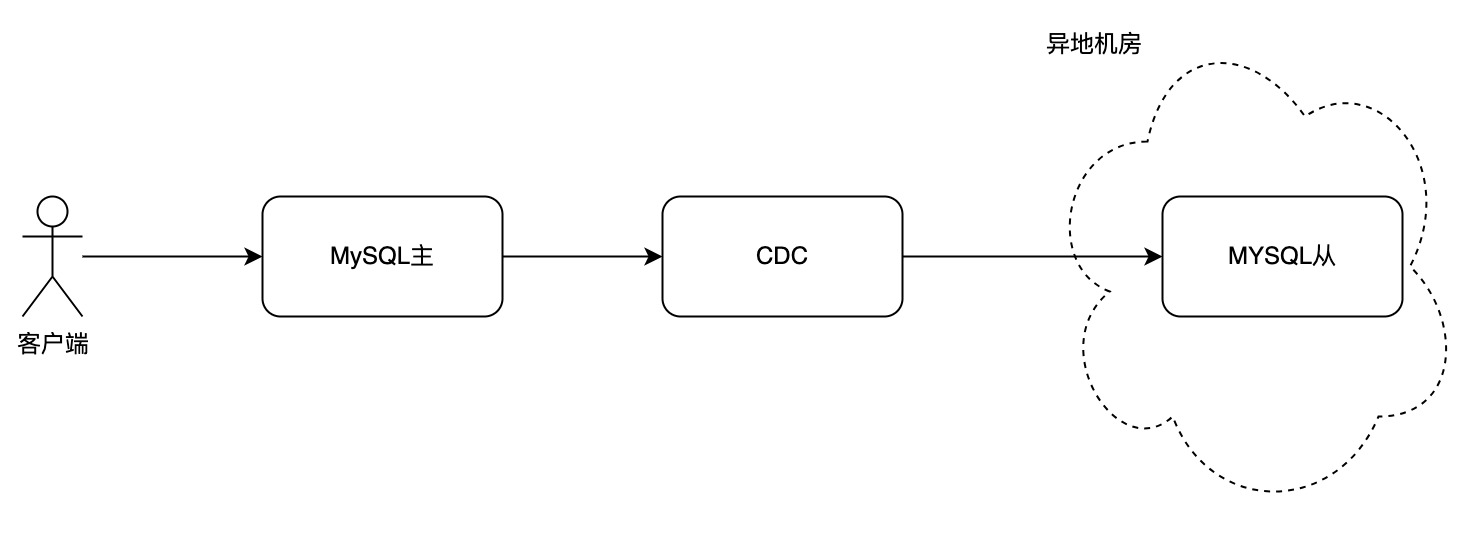
需要注意的是,异地机房复制,由于网络问题可能导致从节点数据迟迟赶不上主节点。对于Redis来说,可能会频繁导致全量复制。异地机房数据复制,通常也可以使用中间件来完成,中间件能模拟数据复制协议,并具备削峰填谷,数据转化,路由等的功能。如下是一个MySQL异地机房复制,使用CDC(Change Data Capture)中间件,如开源debezium
10.5.4 Diskless
复制保证能容错性,当节点宕机时候,从节点可以接管,这是因为主节点的数据已经复制到从节点。目前我们看到的Redis,Kafka,以及本书附带例子lsm-tree。使用了本地磁盘实现了复制。
也可以采用Diskless方案,有状态服务或者数据库将数据持久化到对象存储服务器,对象存储服务器自身会实现数据备份。Kafka支持Diskless,SlateDB只支持对象存储服务。
使用对象存储服务,需要注意到,对象存储服务为了数据可靠保存,通常需要将一份数据存放到多个磁盘上才算存储成功。因此比存放在本地磁盘慢的多,因此通常会定时刷新到对象存储服务上,比如1秒刷新一次。这样最多允许丢失一秒的数据
关于对象存储服务,可以参考开源MinIO。
10.5.6 故障转移
当主节点发生故障或者需要维护的时候,需要自动选择一个从节点提升为为主节点,并告知客户端或者服务代理,提供对外服务。有状态服务集群可以通过俩个如下方式实现故障转移
一个主节点有多个从节点,即数据会复制多份情况下,哪一个从节点最适合当主节点. 通常采用拥有最新数据的从节点。比如Zookeeper集群中,协商选举主节点时候,节点会发送日志文件最近的zxid(zookeeper事务全局编号,随着数据的更新顺序递增),具备最大的zxid将进入候选(后续如果拿到过半投票,即成为领导节点)。如果zxid都一样,最选择myid(zookeeper节点id)最大的作为主节点。如下3个节点,节点1的zxid最大为4,则有可能被选举为领导节点
| 节点 | 预写日志内容-> | |||
|---|---|---|---|---|
| 节点1 | 0x00000001 | 0x00000002 | 0x00000003 | 0x00000004 |
| 节点2 | 0x00000001 | 0x00000002 | ||
| 节点3 | 0x00000001 | 0x00000002 | 0x00000003 |
对于zookeeper这样的集群,它是通过类似Raft协议选举主节点(领导节点),当主节点故障时候,其他从节点会发起重新选取领导节点的过程。关于Raft,将在5.10一致性共识中说明
Redis Cluster也是采用类似zookeeper的方案。它做出如下选择:
- 与主节点断开时间较长的从节点,直接淘汰。
最大允许断开时间 = cluster-node-timeout × cluster-slave-validity-factor. 默认是150秒。 - 比较节点配置replica-priority,最小的成为主节点。这为人工干预选举提供了机会,比如异地机房的节点优先级低
- 如果优先级相同,则比较复制日志的offset,同zxid一样,最大的将成为主节点
- 如果以上值都一样,才使用runid最小的最为主节点,这里的runid是运行id,每次启动时候生成的随机ID